מאחורי ההבטחה ל״בינת־על רפואית״ מסתתרות שתי שאלות יקרות: כמה מוסיפה המערכת למודל שמתחתיה, והאם היתרון ישרוד מפגש עם מטופלים אמיתיים?
83% מול 36%: אלה מספרים שמספיקים כדי לגרום לכל מנהל בית חולים להרים גבה, ולכל מחלקת שיווק להכין מצגת. מערכת האבחון MAI-DxO של מיקרוסופט הצליחה לזהות מחלות במקרים רפואיים מורכבים בשיעור גבוה משמעותית מזה של הרופאים שהשתתפו בניסוי. המחקר פורסם ב־22 באוקטובר ב־Science, ומוסטפא סולימאן, מנהל Microsoft AI, מציג את הכיוון כחלק מהדרך לבינת־על רפואית. אלא שהמרחק בין הישג במבחן לבין מערכת שכדאי להפקיד בידיה החלטות רפואיות עובר בפרטים הקטנים: מי היו הרופאים שנבחנו, איזה מידע קיבלו, כמה עלו הבדיקות, ובעיקר מה בדיוק הוסיפה מיקרוסופט למודלים שכבר היו שם.
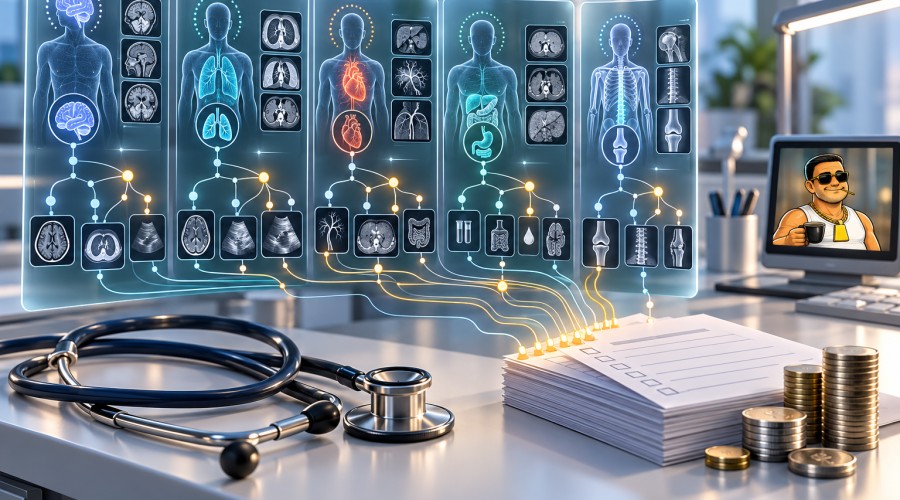
לפי ההסבר שפרסמה מיקרוסופט, המערכת מתפקדת כמעין התייעצות בין רופאים וירטואליים: היא מעלה אפשרויות לאבחנה, בוחרת שאלות ובדיקות, מערערת על ההשערה המובילה ומעדכנת אותה עם קבלת מידע נוסף. סביבת ההערכה, SDBench, נועדה לבחון את התהליך הזה בהדרגה, במקום להציג מראש תיק מלא ולבקש תשובה אחת. מאגר המקרים כלל 304 מקרים מורכבים מ־New England Journal of Medicine, ולצדם נבחן מערך של 325 מקרי מיון מתוך MIMIC-IV-ED. בתוצאות המרכזיות, עם GPT-5, נרשם דיוק של 83.2% במקרים המורכבים, לעומת 36.1% אצל רופאים שנעזרו במקורות מידע. במקרי המיון התקבלו 80.3% מול 46.8%. אלה פערים גדולים, אבל הם מתארים הצלחה במשימת אבחון מוגדרת, בתנאי ניסוי.
כפי שמדגיש הדיווח המקורי ב־TechCrunch, חלק ניכר מהיתרון מגיע ממודלי הבסיס, ולא רק ממנגנון התיאום של מיקרוסופט. זו הבחנה עסקית חשובה: חברה שמחברת כמה סוכנים למערכת אחת צריכה להראות מה החיבור מוסיף מעבר לרכישת גישה למודל חזק. המחקר מדווח על שיפור ממוצע של 7.9 נקודות אחוז במקרים המורכבים ו־4.4 נקודות במקרי המיון בזכות התזמור, לפי סיכום הממצאים ב־Becker’s Hospital Review. כלומר, יש תרומה מדידה, אך גודל התרומה משתנה. חשוב גם לזכור שההשוואה האנושית הייתה מול רופאים כלליים שעבדו לבדם, ולא מול מומחים או צוות רב־תחומי. הניסוי היה טקסטואלי ומבוקר; הוא אינו מוכיח עליונות על העבודה הקלינית כפי שהיא מתנהלת בבית חולים.
גם ההבטחה הכלכלית דורשת לפתוח את החשבון. לפי פירוט התוצאות ב־Medical Economics, ההגדרה שהגיעה ל־83.2% דיוק ללא מגבלת תקציב הניבה עלות בדיקות מוערכת של 5,431 דולר למקרה מורכב, לעומת 4,725 דולר אצל הרופאים. בתצורה עם מגבלת תקציב התקבלו 80.9% דיוק בעלות של 2,241 דולר, לפי הסיכום ב־Becker’s. הדיוק המרבי והחיסכון אינם אותה תוצאה באותה הגדרה. אלה אומדני עלות של הבירור הרפואי בסימולציה, ולא מחיר השימוש בצ׳אטבוט או חיסכון שנמדד בתקציב בית חולים. המערכת גם שאלה בממוצע 25.5 שאלות לפני הבדיקה הראשונה, לעומת 5.6 אצל הרופאים. תשאול יסודי עשוי לחסוך בדיקות; עדיין צריך לברר איך הוא משתלב בזמן ובקשב של מטופלים אמיתיים.
מנקודת מבט ישראלית, זו הזדמנות לחשוב על הרכש לפני שחושבים על הסיסמה. זו פרשנות כלכלית לממצאים: קופה או בית חולים שיבחנו מערכת כזאת יצטרכו למדוד את התוספת שלה למסלול הטיפול המקומי — האם היא מקצרת את הדרך לאבחנה, מפחיתה בדיקות מיותרות ומשפרת החלטות של הצוות. מחירים אמריקאיים אינם מוכיחים חיסכון בישראל, ושיעור הצלחה על תיאורי מקרים אינו עונה על שאלות של עברית רפואית, שילוב בתיק המטופל או התמודדות עם מידע חסר. גם טעות אחת אינה שקולה לאחרת: החמצת מצב דחוף והפניה מיותרת לבדיקה עשויות להיספר שתיהן ככישלון באבחון, אבל המשמעות למטופל ולתקציב שונה מאוד. לכן השוואה שימושית לרוכש תהיה גם בין צוות שמקבל סיוע מהמערכת לבין אותו מסלול עבודה בלעדיו.
מיקרוסופט הודיעה על שיתוף פעולה עם Beth Israel Deaconess Medical Center בבוסטון להערכת יכולות המערכת בסביבות קליניות, כולל אינטראקציה ישירה עם מטופלים והשוואה להערכות עצמאיות של רופאים. זה השלב שעשוי להתחיל לענות על השאלות שהמבחן הנוכחי משאיר פתוחות. בינתיים מדובר במערכת מחקר שנבחנת לקראת שימוש בעולם האמיתי, ולא בשירות אבחון זמין לציבור. ההישג ראוי לתשומת לב: תוכנה שמצליחה לנהל בירור רפואי מדורג יכולה להפוך לכלי משמעותי. אבל את התואר בינת־על רפואית יהיה צריך להרוויח גם מחוץ לטבלת הציונים.