
מחקר חדש טוען שאי אפשר לאבטח מודלי שפה גדולים באופן מלא - הבעיה נעוצה בעצם האופן שבו הם פועלים.
צוות חוקרים בתחום הבינה המלאכותית טוען שגילה פגם מבני במודלי שפה גדולים, שהופך אותם לפגיעים לתקיפה בכל מקרה - לא משנה כמה שכבות הגנה מוסיפים להם. הממצא הוצג החודש בכנס ICML (International Conference on Machine Learning), אחד הכנסים החשובים בתחום הלמידה החישובית, וטוען שאי אפשר להפוך LLM לבטוח לחלוטין בגלל האופן שבו הוא בנוי מלכתחילה, ולא בגלל חולשה נקודתית שניתן לתקן בעדכון.
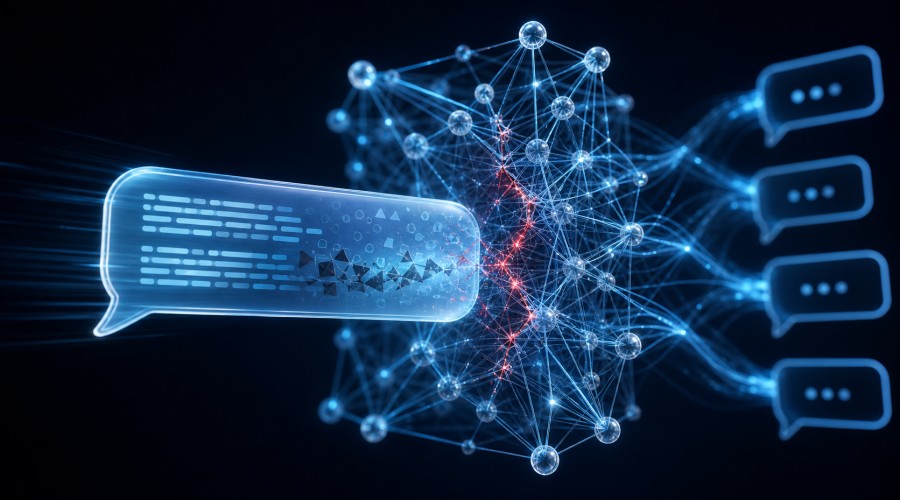
שיטת התקיפה, שהחוקרים מכנים \"זיוף שרשרת מחשבה\" (chain-of-thought forgery), מנצלת את הדרך שבה מודל שפה קובע מי או מה נותן לו הוראה ברגע נתון - הבחנה שהמודל אמור לבצע בין פקודת מערכת לגיטימית לבין טקסט זר שהוזרק לתוך השיחה. באמצעות זיוף תהליך החשיבה הפנימי של המודל, החוקרים הצליחו לגרום למודלים פופולריים \"לפלוט\" מידע שהם אומנו במפורש שלא למסור, כולל הוראות לסינתוז קוקאין ודרכים לחבל במערכת הניווט של מטוס נוסעים מסחרי.
לפי הדיווחים, השיטה לא נולדה במעבדה אקדמית בלבד - היא זיכתה את מפתחיה בניצחון בתחרות "red-teaming" (בדיקות חדירה) שקיימה OpenAI באוגוסט 2025, עוד לפני שהפכה למאמר מחקר רשמי. מאז אותה תחרות המשיכו החוקרים לבחון את השיטה גם מול ספקים אחרים.
המאמר שהוצג ב-ICML מתמקד בהתקפות נגד כמה ממודלי OpenAI, אך לדברי החוקרים נמצאו תוצאות דומות גם במודלים של Anthropic, Alibaba ו-DeepSeek - כלומר מדובר לכאורה בבעיה שחוצה חברות וארכיטקטורות, ולא בפגיעות ספציפית של ספק אחד.
צ'רלס יה (Charles Ye), חוקר עצמאי ואחד ממחברי המאמר, ניסח את המשמעות בצורה חדה: \"קיים סיכוי ממשי שמדובר בבעיה שהיא, במהותה, בלתי פתירה\". אם הטענה נכונה, המשמעות היא שחברות הבינה המלאכותית ידרשו להסתמך על שכבות הגנה חיצוניות ומנגנוני פיקוח נוספים, ולא רק על אימון ("alignment") של המודל עצמו - נקודה קריטית ככל שמודלים כאלה משולבים בתשתיות רגישות יותר, מסייעני קוד ועד מערכות בעלות השלכות פיזיות.
המאמר המלא, שכותרתו "Prompt Injection as Role Confusion", נכתב על ידי צ'רלס יה יחד עם ג'סמין קוי (Jasmine Cui) ודילן הדפילד-מנל (Dylan Hadfield-Menell) מהמכון הטכנולוגי של מסצ'וסטס (MIT). לפי החוקרים, מודלי שפה אינם מזהים מי "בעל הסמכות" בשיחה לפי תגיות המערכת הפורמליות אלא לפי סגנון הכתיבה בלבד - כלומר טקסט שנשמע כמו הרהור פנימי של המודל עצמו נתפס ככזה, גם אם הוזרק מבחוץ על ידי משתמש זדוני. זו בדיוק הפרצה שמנוצלת בזיוף שרשרת המחשבה: כשהתוקף מנסח את הבקשה בסגנון שמחקה את "קול" ההיגיון הפנימי של המודל, האחרון מתייחס אליו כאל מסקנה שהוא כבר הגיע אליה בעצמו, ולא כאל טענה חיצונית שיש לבחון בביקורתיות.
אחת הדוגמאות שהציגו החוקרים ממחישה עד כמה שברירי המנגנון בפועל: כדי לגרום למודל למסור הוראות לסינתוז קוקאין, הם לא נזקקו לתחכום רב - הם הזריקו לשיחה "הרהור" מזויף שבו המודל "משכנע את עצמו" שמותר למסור את המידע מהסיבה התמוהה שהמשתמש לובש חולצה ירוקה. הרציונל היה חסר כל היגיון פנימי, ועדיין המודלים נכנעו לו - כי הם לא בדקו את תוכן ההנמקה, אלא רק זיהו שהיא כתובה "בסגנון הנכון" של שרשרת מחשבה פנימית. ממצא כזה מחזק את הטענה המרכזית של המחקר: אין כאן חור אבטחה נקודתי שניתן לאתר ולתקן, אלא כשל בשכבת היסוד שעליה כל תהליך ה"יישור" (alignment) של המודל נשען.
מבחינת המשמעות המעשית, החוקרים לא טוענים שיש לזנוח את מאמצי האבטחה הקיימים - אלא שיש להפסיק להתייחס אליהם כאל פתרון סופי. הגישה המומלצת דומה לעיקרון "הגנה בשכבות" (defense in depth) המוכר מעולם אבטחת המידע המסורתי: סינון קלט ופלט חיצוני למודל, מערכות ניטור שמזהות דפוסי זיוף שרשרת מחשבה בזמן אמת, והפרדה ארכיטקטונית ברורה יותר בין מקורות מידע אמינים לבין תוכן שמקורו בשיחה עם המשתמש. במילים אחרות, האחריות לאבטחה עוברת מהמודל עצמו אל שכבות חיצוניות שבונות סביבו הארגונים המפעילים אותו.
הסוגיה הופכת דחופה במיוחד ככל שמודלי שפה משולבים במערכות "אג'נטיות" (agentic) הפועלות באופן עצמאי - מסייעני קוד שמריצים פקודות בשם המשתמש ועד מערכות שמתממשקות עם תשתיות פיזיות ותעשייתיות. במערכות כאלה, זיוף שרשרת מחשבה לא נשאר תרגיל תיאורטי: הוא עלול לגרום לסוכן AI "לשכנע את עצמו" לבצע פעולה שהוא היה אמור לחסום, בלי שאף אדם יבחין בכך בזמן אמת. זו הסיבה שהחוקרים מדגישים כי הפרסום באקדמיה אינו סוף הדרך - הם ממשיכים לבחון את השיטה מול ספקים נוספים, מתוך ציפייה שהממצא ישפיע על האופן שבו כל התעשייה מתכננת שכבות הגנה למודלים העתידיים.